Selbstlernkurse
Auf unserer Moodle-Lernplattform erwarten euch verschiedene Selbstlernkurse für die Arbeit mit naturwissenschaftlichen Sammlungen und objektzentrierten Daten. Die Kurse vermitteln zentrale Themen wie den Umgang und die Wiederverwendung von Forschungsdaten, rechtliche und ethische Fragen bei der Feldforschung, die Verbesserung und Anreicherung von Daten, Texterkennung, Machine Learning und Open Science. Für weitere Details, klickt euch durch die Kursbeschreibungen. Bei erfolgreicher Beendigung der einzelnen Kurse erhaltet ihr jeweils ein Zertifikat. Zwischendurch gibt es Badges, also legt los!
Falls ihr Fragen oder Probleme mit der Anmeldung für die einzelnen Kurse in Moodle habt, kontaktiert uns gerne direkt über den Helpdesk.
FDM - Kernkonzepte der Datenqualität im Forschungsdatenmanagement
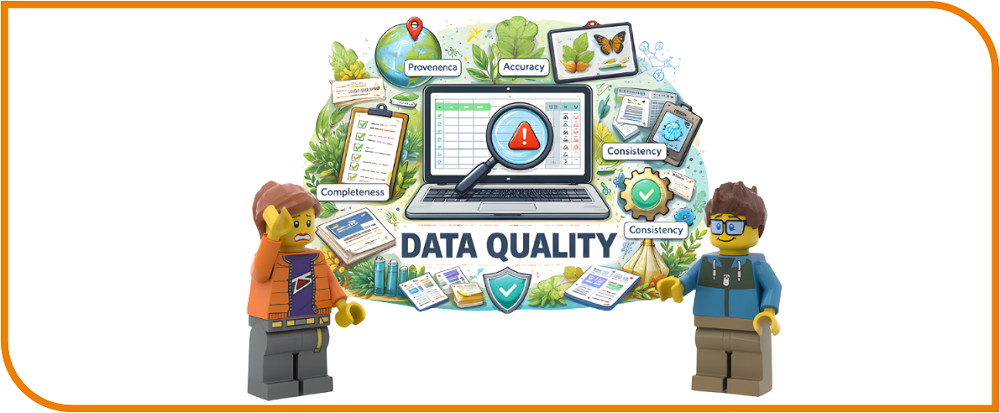
Dieser Kurs führt in die zentralen Dimensionen der Datenqualität bei Forschungsdaten ein – darunter Genauigkeit, Vollständigkeit, Konsistenz und Provenienz – und untersucht, wie diese die Zuverlässigkeit, Nutzbarkeit und Wiederverwendbarkeit von Daten in Forschung und Kuratierung beeinflussen. Die Teilnehmenden lernen Validierungs- und Integritätsprüfungen kennen, die eine reproduzierbare Forschung unterstützen, analysieren typische Probleme der Datenqualität mithilfe praxisnaher Werkzeuge und Arbeitsabläufe und entwickeln die Fähigkeit zu beurteilen, ob Datensätze für den jeweiligen Zweck geeignet sind und wie deren Qualität überwacht und verbessert werden kann.
>> Hier in Moodle registrieren und direkt für den Kurs anmelden
FDM - Data Governance: Strategien zur Qualitätsverbesserung von Sammlungsdaten
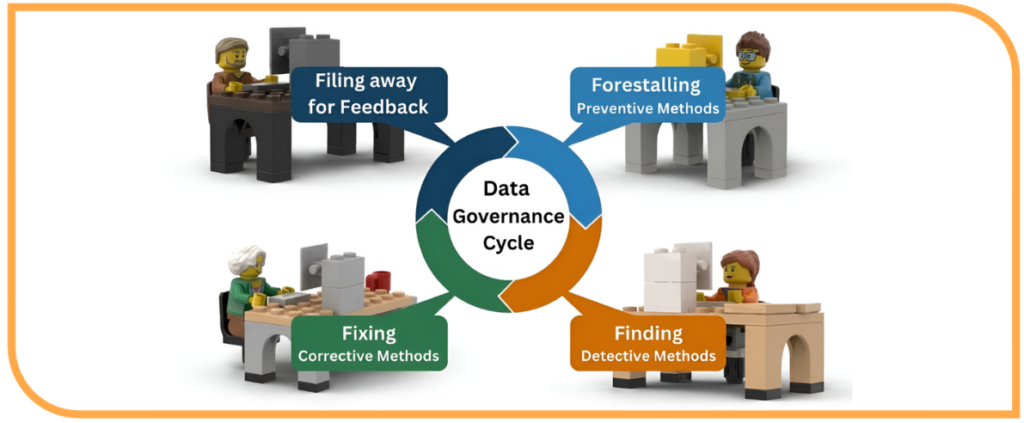
Dieser Online-Kurs macht die Teilnehmenden mit den Vorteilen (institutioneller) Data-Governance-Konzepte für die Überwachung der Datenqualität vertraut. Im Mittelpunkt stehen operative Verfahren zur Erkennung und Vermeidung von Problemen, wie etwa automatisierte Prüfungen, manuelle Kontrollen mittels Checklisten sowie regelbasierte Validierungen. Die Teilnehmenden lernen, wie sie einen schlanken Ansatz für das Monitoring konzipieren können.
Nach Abschluss des Kurses sind die Teilnehmenden in der Lage, die Rollen, Aufgaben und Arbeitsabläufe zu verstehen, die für eine kontinuierliche Verbesserung der Datenqualität erforderlich sind. Sie kennen gängige Werkzeuge und Methoden zur Überwachung der Datenqualität, können festgestellte Probleme analysieren, deren Ursachen ermitteln und (teil-)automatisierte Maßnahmen zur Vermeidung erneuter Fehler implementieren.
>> Hier in Moodle registrieren und direkt für den Kurs anmelden
Recherche, Nachnutzung und Publikation objektbezogener Daten nach den FAIR-Prinzipien -Teil 1: Wiederverwendbarkeit und ihre Bedeutung
Teil 1 – Wiederverwendbarkeit und ihre Bedeutung
Dieser Kursteil führt in das Konzept der Wiederverwendung von Forschungsdaten sowie dessen Bedeutung für objektbezogene Forschungsdaten ein. Er erläutert, wie sich die Wiederverwendung von Reproduktion und Replikation unterscheidet, warum eine Dokumentation für die Überprüfung, Bewertung und spätere Wiederverwendung unerlässlich ist und auf welche Weise die Wiederverwendung Qualitätskontrolle, Effizienz, Zusammenarbeit, Langzeitarchivierung sowie neue Forschungskontexte unterstützt.
Recherche, Nachnutzung und Publikation objektbezogener Daten nach den FAIR-Prinzipien - Teil 2: Wiederverwendung objektbezogener Forschungsdaten
Teil 2 – Wiederverwendung objektbezogener Forschungsdaten
Dieser Kursteil führt in die verantwortungsvolle, rechtlich und ethisch korrekte sowie effiziente Wiederverwendung objektbezogener Forschungsdaten (z. B. biologische Proben, genetisches Material oder sammlungsbasierte Objekte) in neuen Forschungskontexten ein.
Die Teilnehmenden lernen die wesentlichen Voraussetzungen für die Wiederverwendung kennen, darunter rechtliche Genehmigungen, ethische Aspekte, technische Zugänglichkeit, Dokumentations- und Inhaltsqualität, Datenzitierung, persistente Identifikatoren sowie Open-Science-Praktiken.
Regelwerke für Forschungsprojekte mit Datenerhebung im Feld
Dieser Kurs vermittelt einen Überblick über die rechtlichen, ethischen und institutionellen Rahmenbedingungen für Feldforschung und Probenahme, einschließlich zentraler Prinzipien und Regelwerke wie CARE, FPIC und das Nagoya-Protokoll. Anhand von Fallstudien und Simulationen lernen die Teilnehmenden, Stakeholder zu identifizieren, Genehmigungs- und Beteiligungsprozesse zu steuern sowie Risiken und Planungen in Forschungsprojekten kritisch zu bewerten.
>> Hier in Moodle registrieren und direkt für den Kurs anmelden
ATR 1 – Einführung: Grundkonzepte, Terminologie und Arbeitsablauf der automatischen Texterkennung (ATR)
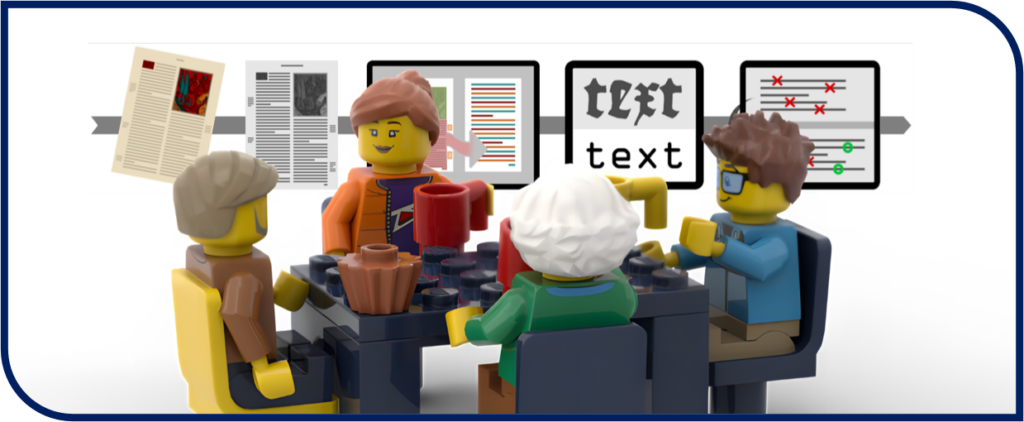
Dieser Kurs vermittelt die grundlegenden Konzepte und Arbeitsabläufe der automatischen Texterkennung (ATR). Dazu gehören die Zusammenstellung und Aufbereitung des Textkorpus, gängige Software und Transkriptionsplattformen sowie bewährte Verfahren zur Feinabstimmung vorhandener Textmodelle auf das eigene Korpus. Nach Abschluss der gesamten Kursreihe sollen die Teilnehmenden in der Lage sein, Nutzen und Aufwand der ATR für ihre eigenen Forschungsprojekte einzuschätzen und gängige Plattformen (z. B. eScriptorium, OCR4All, Transkribus) selbst auszuprobieren.
>> Hier in Moodle registrieren und direkt für den Kurs anmelden
ATR 2 – Vertiefung: Vorverarbeitung und Softwareauswahl
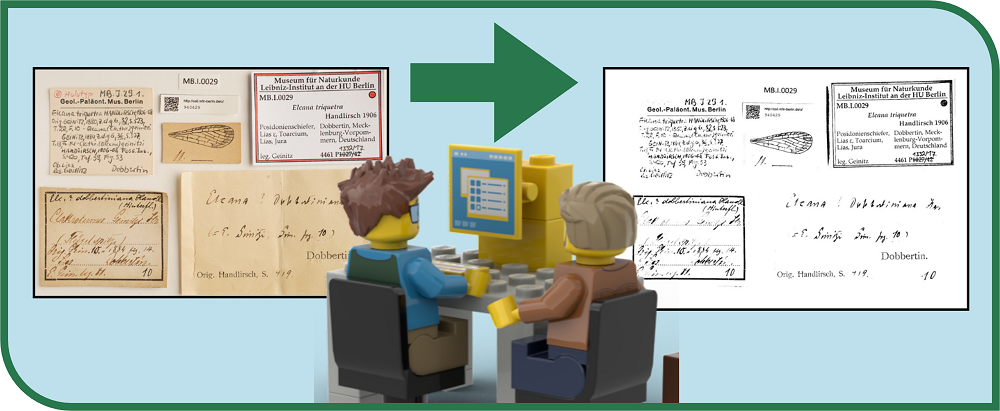
Dieser Kurs bietet eine fundierte Einführung in alle Arbeitsschritte, die zur Vorbereitung eines Textkorpus für die Transkription erforderlich sind. Ihr lernt gängige Importformate für Textkorpora, die Bedeutung der Vorverarbeitung und Qualitätskriterien für Importdateien kennen sowie verbreitete Softwarelösungen und Strategien zur Optimierung von Importdateien (Rauschunterdrückung, Graustufen, Binarisierung usw.). Nach Abschluss der gesamten Kursreihe sind die Teilnehmenden in der Lage, Nutzen und Aufwand von ATR für ihre eigenen Forschungsprojekte zu bewerten und gängige Plattformen (z. B. eScriptorium, OCR4All, Transkribus) selbst auszuprobieren.
>> Hier in Moodle registrieren und direkt für den Kurs anmelden
ATR 3 – Vertiefung: Transkription und semantische Anreicherung
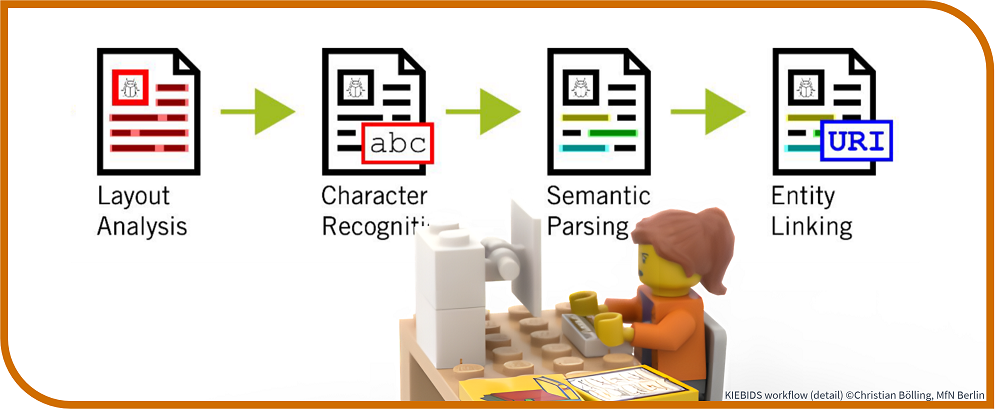
Dieser Kurs bietet eine fundierte Einführung in alle Arbeitsschritte, die für die eigentliche Transkription eines Textkorpus relevant sind – etwa die Festlegung konsistenter und gut dokumentierter Transkriptionsregeln, Layout- und Zeilensegmentierung sowie eine Einführung in die Bedeutung und den Nutzen von strukturellen und textuellen Annotationen, NLP und NER.
>> Hier in Moodle registrieren und direkt für den Kurs anmelden
ATR 4 – Vertiefung: Modelltraining und Veröffentlichung
Dieser Kurs bietet eine fundierte Einführung in die iterativen Prozesse des Modelltrainings: die Feinabstimmung einer „Ground Truth“ für den eigenen Textkorpus auf der Basis bestehender Textmodelle, die Überprüfung und Evaluierung der Ergebnisse anhand von Validierungs- und Testdaten sowie die Erstellung eines Pakets zur Modellreplikation. Nach Abschluss der gesamten Kursreihe sollen die Teilnehmenden in der Lage sein, Nutzen und Aufwand von ATR für ihre eigenen Forschungsprojekte einzuschätzen und gängige Plattformen (z. B. eScriptorium, OCR4All, Transkribus) selbst auszuprobieren.
>> Hier in Moodle registrieren und direkt für den Kurs anmelden
Anreicherung & Kontextualisierung von objektbezogenen Sammlungsdaten
Dieser Kurs bietet eine Einführung in die Harmonisierung, Validierung, Anreicherung und Kontextualisierung von Objekt- und Funddaten. Anhand praktischer Beispiele wird gezeigt, wie semantische Anreicherung mit Normdaten und Taxonomien heterogene Rohdaten in strukturierte und vernetzte Forschungsdaten überführt.
[bald verfügbar]
Open Science für die objektzentrierte Forschung
Dieser Kurs vermittelt die Prinzipien von Open Science und deren Beitrag zum wissenschaftlichen und gesellschaftlichen Fortschritt, mit Schwerpunkt auf der Integration in die Forschung mit objektbezogenen naturwissenschaftlichen Daten. Die Teilnehmenden lernen, nach Open-Science-Prinzipien zu publizieren und reflektieren praktische, politische und kulturelle Herausforderungen bei der Umsetzung.
[bald verfügbar]
